Download Wavify – Fortgeschrittenes KI-Sprachintegrations-Tool
Übersicht
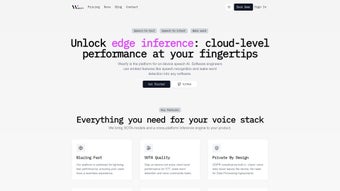
Wavify ist eine hochmoderne KI-Sprachintegrationsplattform, die für Entwickler entwickelt wurde, die natürliche Sprachinteraktion in ihre Anwendungen einbetten möchten, ohne die Privatsphäre oder Leistung zu beeinträchtigen. Angetrieben von einer On‑Device‑Architektur verarbeitet Wavify Sprachdaten lokal und garantiert, dass Benutzeraufnahmen das Gerät nie verlassen, während gleichzeitig cloud‑ähnliche Genauigkeit für Speech‑to‑Text (STT), Wake‑Word‑Erkennung und Befehlsverarbeitung bereitgestellt wird. Diese Kombination aus Sicherheit, Geschwindigkeit und Skalierbarkeit macht Wavify zur idealen Wahl für hochreaktive Umgebungen wie Gesundheitsüberwachung, Automotive‑Infotainment und E‑Learning‑Tools.
Was Wavify wirklich von generischen Voice‑SDKs unterscheidet, ist seine mehrsprachige Engine und die Breite der unterstützten Plattformen. Egal, ob Sie einen Linux‑Server, einen Windows‑Desktop, einen macOS‑Client, eine iOS‑Mobile‑App, ein Android‑Gerät oder sogar ein ressourcenbeschränktes Embedded‑Board anvisieren, Wavify bietet eine konsistente API‑Oberfläche und Dokumentation, die den Integrationsaufwand auf wenige Code‑Zeilen reduziert. Das modulare Design der Plattform ermöglicht es Ihnen, nur die Funktionen zu aktivieren, die Sie benötigen – sei es einfaches Keyword‑Spotting oder vollwertige konversationale KI – sodass Sie die Binärgröße klein und den Stromverbrauch niedrig halten können.
Zusätzlich zu den Kern‑Sprachfunktionen bietet Wavify erweiterte Werkzeuge wie benutzerdefiniertes Modell‑Training, Echtzeit‑Sprachwechsel und nahtloses Fallback zu Cloud‑Diensten, wenn ein Gerät eine bestimmte Latenzanforderung nicht erfüllen kann. Das SDK enthält robustes Logging, Diagnostik und Over‑the‑Air‑Update‑Mechanismen, die sicherstellen, dass Ihre sprachaktivierte App stets mit den neuesten Verbesserungen im akustischen Modellieren und im Verständnis natürlicher Sprache auf dem Laufenden bleibt.
Wichtige Funktionen & Fähigkeiten
- On‑Device-Spracherkennung: STT mit niedriger Latenz und datenschutz‑erster Verarbeitung.
- Wake‑Word-Erkennung: Anpassbare Hot‑Words, die Ihre App aktivieren, ohne den Bildschirm zu berühren.
- Sprachbefehls‑Verarbeitung: Eingebaute Intent‑Analyse für schnelle Befehlsausführung.
- Mehrsprachige Unterstützung: Über 30 Sprachen und Dialekte mit automatischer Spracherkennung.
- Plattformübergreifende Kompatibilität: Native SDKs für Linux, Windows, macOS, iOS, Android und Embedded‑Linux.
- Benutzerdefiniertes Modell‑Training: Laden Sie domänenspezifische Datensätze hoch, um akustische und Sprachmodelle fein abzustimmen.
- Hybrid‑Cloud‑Fallback: Nahtloser Wechsel zur Cloud‑Verarbeitung, wenn On‑Device‑Ressourcen unzureichend sind.
- Echtzeit‑Updates: OTA‑Modell‑ und Firmware‑Updates, ohne die Benutzererfahrung zu stören.
- Entwickler‑freundliche API: Einfaches JSON‑basiertes Anfrage‑/Antwort‑Modell mit umfangreichen Code‑Beispielen.
- Sicherheits‑ & Datenschutz‑Kontrollen: End‑to‑End‑Verschlüsselung, sandboxed Ausführung und DSGVO‑konforme Datenverarbeitung.
Jede Funktion wird über ein gut dokumentiertes Set von Funktionen bereitgestellt, die aus gängigen Sprachen wie C++, Java, Swift, Kotlin und Python aufgerufen werden können. Das SDK enthält zudem eine visuelle Debug‑Konsole, die Entwicklern ermöglicht, Echtzeit‑Transkriptionen, Vertrauenswerte und akustische Wellenformen direkt auf dem Gerät zu sehen. Dieses Maß an Einblick beschleunigt die Fehlersuche und hilft Ihnen, das Spracherlebnis für Ihre Zielgruppe fein abzustimmen.
Da Wavify auf branchenüblichen neuronalen Netzwerk‑Architekturen aufbaut, sind die Modelle sowohl leichtgewichtig als auch hochpräzise. Die Plattform nutzt Quantisierungs‑ und Pruning‑Techniken, um den Speicherbedarf auf den meisten Mobilgeräten unter 30 MB zu halten, während gleichzeitig Wortfehlerraten (WER) erreicht werden, die mit führenden Cloud‑Diensten vergleichbar sind. Für Anwendungen, die höchste Präzision erfordern – wie medizinische Diktate oder Fahrzeug‑Sprachbefehle – bietet Wavify eine Premium‑Modell‑Stufe mit unter 5 % WER in lauten Umgebungen.
Installation, Nutzung & Kompatibilität
Erste Schritte
Die Installation von Wavify ist unkompliziert. Für Windows und macOS laden Sie den Installer von der offiziellen Website herunter; das Paket enthält vorkompilierte Binärdateien, SDK‑Header und Beispielprojekte. Linux‑Nutzer können ein .deb‑ oder .rpm‑Paket über die Befehlszeile beziehen, während Mobile‑Entwickler das Android‑AAR oder das iOS‑CocoaPod direkt von Maven Central bzw.
CocoaPods erhalten. Embedded‑Systeme werden über eine cross‑kompilierte statische Bibliothek unterstützt, die mit Ihrem Firmware‑Build‑System (z. B.
Yocto, Buildroot) verlinkt werden kann.
Nach der Installation des SDK fügen Sie die entsprechenden Include‑Pfade hinzu und verlinken gegen die libwavify-Bibliothek. Ein minimales „Hello Voice“-Beispiel zeigt, wie die Engine initialisiert, ein Wake‑Word‑Modell geladen und eine kontinuierliche Hörschleife gestartet wird. Der Beispielcode ist in C++ für Desktop‑Plattformen und in Swift/Kotlin für Mobile verfügbar, sodass Sie schnell auf jedem Zielgerät prototypisieren können.
Typischer Integrationsablauf
- Engine initialisieren: Rufen Sie
Wavify::initialize()mit Ihrem API‑Schlüssel und der gewünschten Konfiguration (Sprache, Modell‑Stufe, Datenschutz‑Modus) auf. - Ressourcen laden: Laden Sie Wake‑Word‑ und Sprachmodelle mit
loadModel(). Sie können auch eine benutzerdefinierte Grammatikdatei für die Befehlserkennung bereitstellen. - Audioaufnahme starten: Verbinden Sie das SDK mit Ihrem Mikrofoneingang. Wavify unterstützt PCM, WAV und Roh‑Audio‑Streams.
- Ereignisse verarbeiten: Registrieren Sie Callbacks für
onWakeWordDetected,onTranscriptionResultundonError. Die Callbacks laufen in einem Hintergrund‑Thread, daher müssen UI‑Updates zum Haupt‑Thread weitergeleitet werden. - Ergebnisse verarbeiten: Verwenden Sie die zurückgegebene JSON‑Payload, um Intent, Vertrauen und extrahierte Entitäten (z. B. Daten, Zahlen) zu extrahieren.
- Sauber herunterfahren: Geben Sie Ressourcen mit
Wavify::shutdown()frei, wenn die App beendet wird.
Betriebssystemunterstützung
Wavify läuft nativ auf den folgenden Plattformen:
- Windows 10/11 (x86 64)
- macOS 12 Monterey and later (Apple Silicon & Intel)
- Ubuntu 20.04+, Debian, Fedora, and other major Linux distributions
- iOS 14+ (iPhone, iPad)
- Android 8.0 Oreo and later
- Embedded Linux (ARM Cortex‑A, AArch64) with glibc or musl
Das SDK abstrahiert plattformspezifische Audio‑APIs und bietet eine einheitliche Schnittstelle für Mikrofonaufnahme und Audiowiedergabe. Das stellt sicher, dass Entwickler einen einzigen Code‑Base schreiben können, der auf allen unterstützten Geräten konsistent funktioniert, wodurch Wartungsaufwand reduziert und Release‑Zyklen beschleunigt werden.
Vorteile, Nachteile & Häufig gestellte Fragen
Vorteile
- On‑Device-Verarbeitung schützt die Privatsphäre der Nutzer und reduziert die Latenz.
- Umfangreiche mehrsprachige Unterstützung ermöglicht globale Einsätze.
- Plattformübergreifende SDKs vereinfachen die Integration über Desktop, Mobile und Embedded.
- Benutzerdefiniertes Modell‑Training passt die Engine an domänenspezifische Vokabulare an.
- Hybrid‑Cloud‑Fallback garantiert Zuverlässigkeit in ressourcenarmen Szenarien.
Nachteile
- Anfängliche Lernkurve für Entwickler, die mit Audio‑Pipelines nicht vertraut sind.
- Erweiterte Funktionen (z. B. benutzerdefiniertes Modell‑Training) erfordern ein kostenpflichtiges Abonnement.
- Embedded‑Deployments können bei älterer Hardware ein sorgfältiges Speicher‑Budget erfordern.
- Die Dokumentation ist umfassend, könnte jedoch von mehr Video‑Tutorials profitieren.
- Die Genauigkeit der Echtzeit‑Transkription kann in extrem lauten Umgebungen ohne zusätzliche Rauschunterdrückungs‑Vorverarbeitung abnehmen.
FAQ
Ist Wavify für persönliche Projekte kostenlos nutzbar?
Ja, Wavify bietet eine kostenlose Stufe, die grundlegendes Speech‑to‑Text, Wake‑Word‑Erkennung und Unterstützung für bis zu drei Sprachen umfasst. Die kostenlose Stufe ist ideal für Hobbyisten, Prototypen und klein‑skalige Anwendungen. Für kommerzielle Nutzung oder erweiterte Funktionen wie benutzerdefiniertes Modell‑Training müssen Sie zu einem kostenpflichtigen Plan upgraden.
Wie stellt Wavify den Datenschutz sicher?
Die gesamte Audioverarbeitung erfolgt lokal auf dem Gerät, das heißt, keine Roh‑Sprachdaten werden an externe Server übertragen. Nur anonymisierte Nutzungsmetriken werden optional für Analysen gesendet, und diese können in der Konfigurationsdatei deaktiviert werden. Wavify entspricht den Vorgaben von DSGVO, CCPA und anderen regionalen Datenschutzbestimmungen.
Kann ich Wavify auf einem Raspberry Pi verwenden?
Absolut. Wavify stellt eine vorkompilierte ARM32/ARM64‑Bibliothek für Raspberry Pi OS bereit. Das SDK läuft effizient auf dem Pi 4 und liefert eine Latenz von unter 200 ms für Wake‑Word‑Erkennung und unter 500 ms für vollständiges Speech‑to‑Text mit einem Standard‑2 GB‑Modell.
Welche Sprachen werden standardmäßig unterstützt?
Wavify unterstützt Englisch, Spanisch, Mandarin, Französisch, Deutsch, Japanisch, Koreanisch, Portugiesisch, Italienisch, Niederländisch, Russisch, Arabisch, Hindi und viele regionale Dialekte. Weitere Sprachen können über die benutzerdefinierte Modell‑Pipeline hinzugefügt werden, die es Ihnen ermöglicht, Sprachpakete hochzuladen, die von der Partner‑Community von Wavify bereitgestellt werden.
Wie erhalte ich Updates für das SDK?
Wavify enthält ein OTA‑ (over‑the‑air) Update‑Modul, das beim Start nach neuen Modell‑ oder Engine‑Versionen sucht. Sie können die neueste Version auch manuell von der Website oder über Paket‑Manager wie npm (für JavaScript‑Wrapper) und pip (für Python‑Bindings) herunterladen.
Fazit – Sollten Sie Wavify herunterladen?
Wenn Sie ein Entwickler sind, der eine zuverlässige, datenschutz‑fokussierte Sprachengine sucht, die auf Desktop-, Mobile- und Embedded‑Plattformen funktioniert, ist Wavify eine überzeugende Wahl. Die On‑Device‑Verarbeitung liefert schnelle, reaktionsfähige Interaktionen, während die umfangreiche mehrsprachige Unterstützung Türen zu globalen Märkten öffnet. Das modulare Design des SDK ermöglicht es Ihnen, mit einfacher Wake‑Word‑Erkennung zu beginnen und nach und nach anspruchsvolle STT‑ oder benutzerdefinierte Sprachmodelle hinzuzufügen, wenn Ihr Produkt reift.
Die kostenlose Stufe bietet ausreichend Funktionalität für Experimente und kleine Projekte, und die kostenpflichtigen Pläne schalten Enterprise‑Funktionen wie benutzerdefiniertes Modell‑Training, Prioritäts‑Support und hochgenauere Modelle frei. Obwohl die Lernkurve für Neulinge im Audio‑Engineering etwas steil sein kann, erleichtern die umfassende Dokumentation, Beispielcode und aktive Community‑Foren den Einstieg.
Kurz gesagt, Wavify vereint Leistung, Sicherheit und Flexibilität auf eine Weise, die nur wenige Wettbewerber erreichen. Ob Sie ein sprachgesteuertes Smart‑Appliance, ein freihändiges medizinisches Diktier‑Tool oder eine Bildungs‑Sprachlern‑App entwickeln – Wavify liefert die Bausteine, um ein ausgereiftes, interaktives Erlebnis zu schaffen. Laden Sie Wavify noch heute herunter und beginnen Sie, gesprochene Worte in leistungsstarke Aktionen innerhalb Ihrer Software zu verwandeln.
Klicken Sie hier, um die neueste Version herunterzuladen und erkunden Sie den kostenlosen Entwickler‑Sandbox. Für Preise, Support‑Optionen und detaillierte technische Spezifikationen besuchen Sie die offizielle Wavify‑Website.
Wavify beeindruckt mit seiner On‑Device‑Verarbeitung, umfangreicher Sprachabdeckung und nahtloser plattformübergreifender Unterstützung. Während die Dokumentation mehr visuelle Anleitungen gebrauchen könnte und der Embedded‑Footprint sehr schwache Hardware herausfordern kann, ist der Gesamtnutzen für Entwickler, die Sprachinteraktivität hinzufügen möchten, hoch. Die kostenlose Stufe ist großzügig, und die Premium‑Funktionen rechtfertigen den Preis für kommerzielle Deployments.